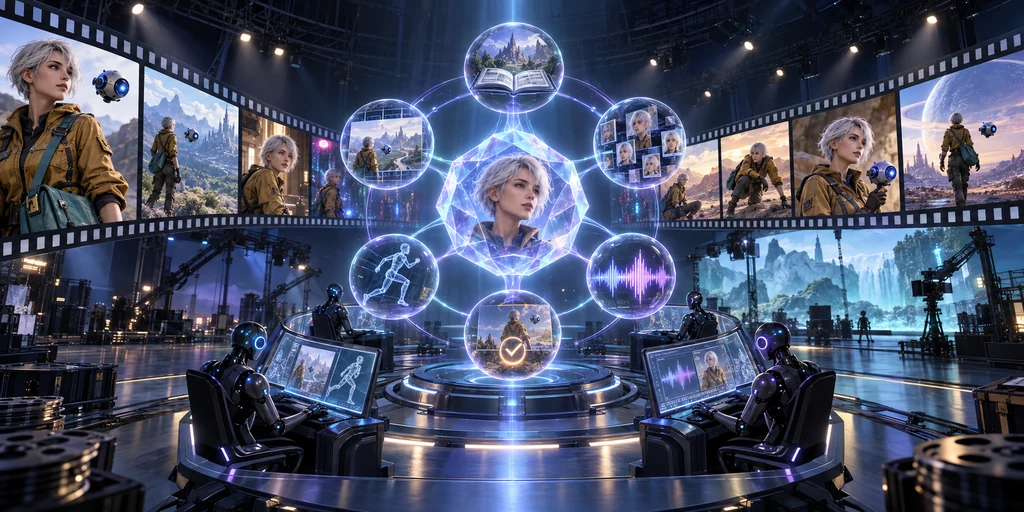
AI動画モデルは数秒の場面なら驚くほど自然です。しかし複数のショットをつなぐと、同じ人物の服が変わり、置いた小物が消え、戻ってきた部屋の構造まで変わります。個別クリップは美しくても、物語全体は少しずつ崩れます。
2026年9月24日、Google Researchはこの問題を単一モデルの性能競争ではなく、全体計画、世界状態、長期的な視覚記憶、反復評価の問題として捉える研究群を公開しました。監督、絵コンテ、キーフレーム、映像、音響、検査を協調エージェントへ分け、完成結果を作品全体の意図と再比較します。
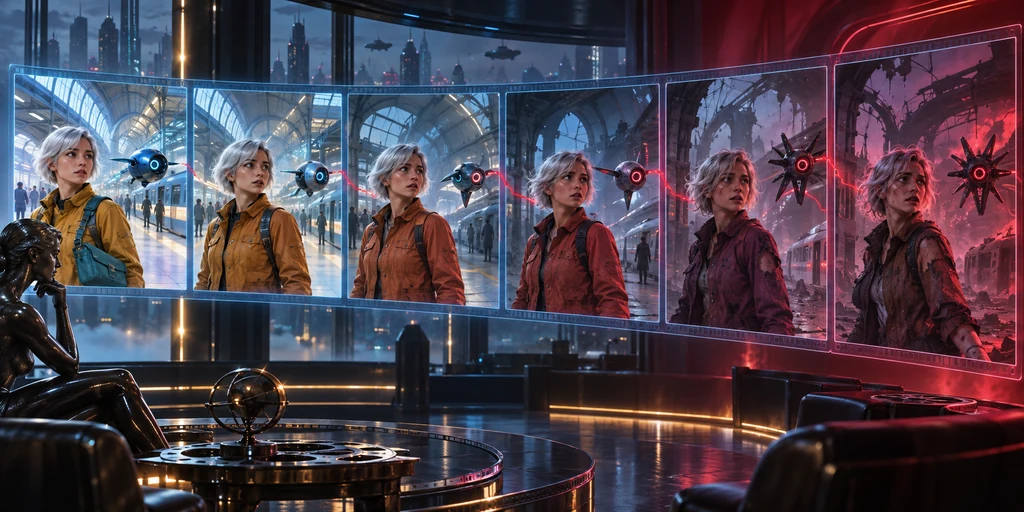
良い一場面と一貫した作品は別の目標
線形工程では、台本から画像、画像からクリップ、クリップから編集列を作ります。初期の小さな誤りが後工程の入力となり、最終版が失敗しても原因の指示や素材を特定しにくくなります。
| 失敗 | 画面の症状 | 構造的原因 |
|---|---|---|
| 人物のドリフト | 顔・服・体形が変化 | 各ショットで人物を再解釈 |
| 空間のドリフト | 扉・窓・動線が移動 | 場所の持続状態がない |
| 小物状態の誤り | 消失・複製・持ち手変更 | 行動前後を追跡しない |
| 物語の崩壊 | 動くが展開しない | 局所クリップだけを最適化 |
| 連鎖失敗 | 悪い基準画像が後続へ伝播 | 中間検査と巻戻しが不足 |
プロンプトを長くするだけでは解決しません。全設定の反復は条件衝突を増やし、固定すべき値を埋没させます。必要なのは、固定要素と変化要素を明示的に管理する制作状態です。
四つの研究が別々のボトルネックを担う
Googleは四研究を一つの制作構造として紹介しています。Co-DirectorとCANVASはCOLM 2026、EMNLP 2026に採択予定とされ、A²RDとVQQAはarXiv研究です。数値は製品保証や独立再現ではなく著者報告値として読む必要があります。
| 構成 | 対象問題 | 中心機構 | 制作者への示唆 |
|---|---|---|---|
| Co-Director | 作品全体の方向 | 戦略・物語・美学の全体探索 | ショット前に作品契約を固定 |
| CANVAS | 人物・場所・小物の連続性 | 持続視覚記憶と世界状態 | 人物・空間・小物台帳を分離 |
| A²RD | 長時間の進行と再登場 | 検索→生成→修正→更新 | 新展開と再固定を区別 |
| VQQA | 誤り発見と再生成 | 視覚質問と全候補選択 | 最後ではなく最良版を選択 |
Co-Directorは作品の意図、物語形式、映像トーンを上位で選び、下位エージェントを同じ方向へ導きます。完成版をマルチモーダル審査モデルが評価し、次の探索へ要因別の信号を返します。論文では400件の架空広告場面からなるGenAD-Benchで評価しています。
視覚記憶は参照画像フォルダより具体的であるべき
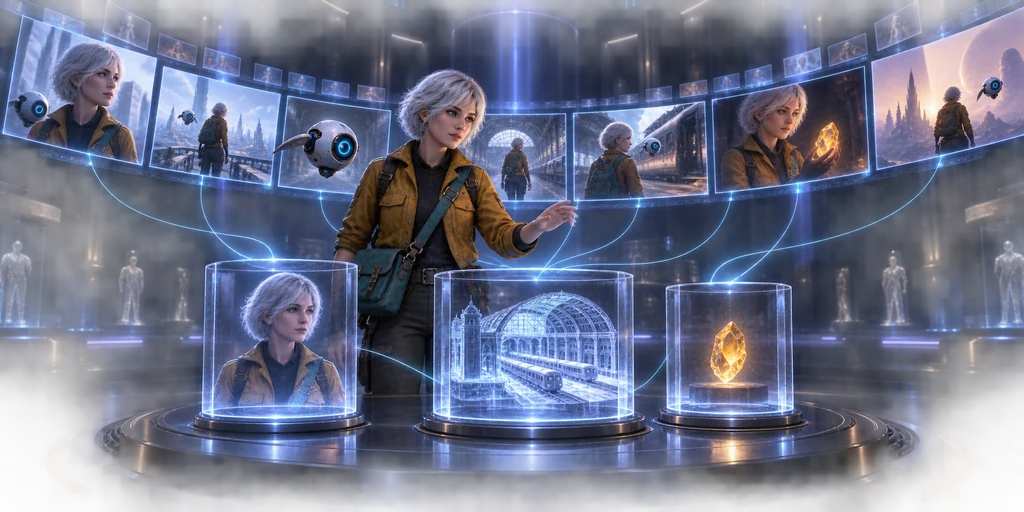
CANVASは人物、場所、物体を構造化し、再登場時に視覚アンカーを検索します。論文は最良の比較対象に対し背景連続性21.6%、人物9.6%、小物7.6%の改善を報告しました。重要なのは単一の数値より、状態が時間とともに変わることを明示する設計です。
上着の色は人物の固定属性です。鍵が机から手へ移るのは変化する小物状態です。駅の柱間隔は空間アンカー、画面方向は撮影制約です。一枚のキャラクターシートへ混ぜると、どの種類の誤りを直すべきか判断できません。
長時間生成とは、継続ではなく検索と更新
A²RDは映像を区間ごとに作り、マルチモーダル記憶を検索し、生成、評価、状態更新を繰り返します。物語を進める場面では外挿的な方式を、既存人物や場所へ戻る場面では補間的な固定を選びます。
著者らは1〜10分の評価で一貫性最大30%、物語凝集性最大20%の改善を報告しました。これは特定のベンチマークと研究条件の結果です。実制作では呼出回数、再生成費、編集時間、人が修正した割合も測る必要があります。
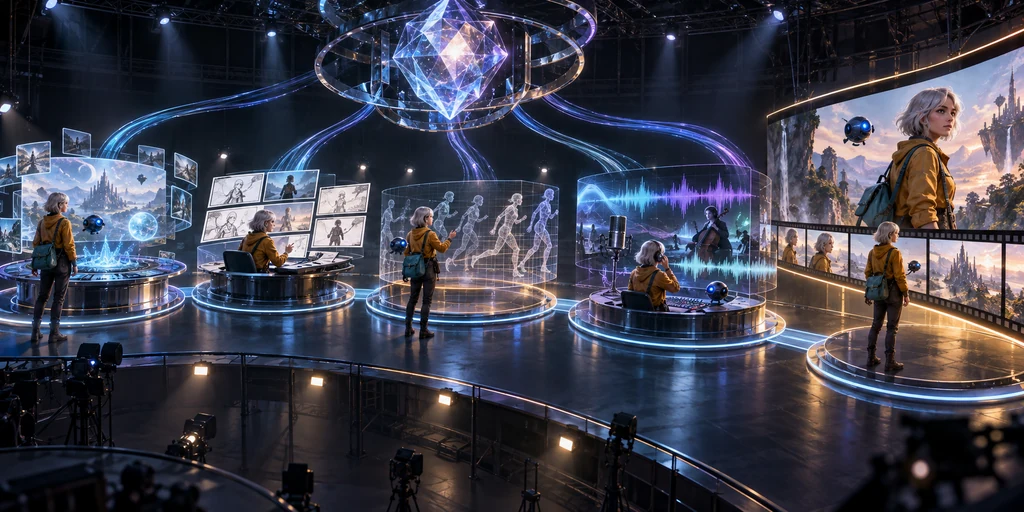
評価は一つの点数ではなく、答えられる質問にする
VQQAは動画ごとに具体的な視覚質問を作ります。「箱形の風船に膨らんだ材質があるか」「カット後も同じ演奏者が同じ楽器を持つか」のような質問で誤りを発見し、その答えを指示修正へ使います。
最後の反復結果を自動採用もしません。局所修正が別の属性や原意図を壊す場合があるため、全候補を最初の指示と再比較します。論文は通常生成に対しT2V-CompBenchで11.57ポイント、VBench2で8.43ポイントの絶対改善を報告しました。
現在の制作者が使える最小構造
研究システムをそのまま使えなくても、運用方式は導入できます。
- 一枚の作品契約を固定する。 観客、意図、物語形式、視覚トーン、禁止事項を記します。
- 三つの台帳を分ける。 人物同一性、場所の空間構造、小物の現在状態を管理します。
- 承認済みキーフレームだけをアンカーにする。 最初の生成物を無条件で後工程へ渡しません。
- ショット指示を差分で書く。 今回変わる行動、カメラ、状態だけを明示します。
- 各ショットへ質問型検査を作る。 顔、服、手、小物、画面軸、空間、行動結果、音を確認します。
- 全候補履歴から選ぶ。 修正後も最初の意図と比較します。
| 制作物 | 必須内容 | 合格条件 |
|---|---|---|
| 作品契約 | 意図・物語・美学・禁止事項 | 全ショットが同一作品に見える |
| 世界状態台帳 | 人物・空間・小物の固定値と変化 | カット前後を説明できる |
| 承認キーフレーム | 基準顔・服・空間・光 | 信頼できる生成アンカー |
| ショット差分 | 開始状態・行動・終了・カメラ | 一ショット一主要変化 |
| 質問型QA | Yes/No質問と証拠フレーム | 失敗位置と修正が具体的 |
まだ解決されていないこと
この研究群は長編生成が単一プロンプトから制作システムへ移る強い兆候です。ただし公開情報だけでは実運用の費用、遅延、失敗率、編集性を判断できません。ベンチマークは繊細な演技、文化的文脈、法的確認、観客判断を代替しません。
人物の肖像・音声、参照素材の権利、生成物表示、媒体規約も確認が必要です。GoogleはGeminiとVeoのSynthIDを引き継ぐと説明しますが、透かしは所有権や事実性を証明しません。作品方向、基準画像承認、最終編集は責任ある人が統制すべきです。
結論:次の競争は長さではなく制作記憶
ボトルネックは数秒を追加することではありません。物語全体の約束を守り、世界の変化を記憶し、誤りの発生点へ戻って部分修正する能力です。
将来の動画ツールは一つの生成ボタンより、監督、記憶、評価、版選択を結ぶ制作OSに近づくでしょう。今できる現実的な準備は長いプロンプトではなく、作品契約、状態台帳、承認アンカー、答えられるQA質問を作ることです。
主要資料
- Google Research: Automating coherent long-form video generation
- Co-Director: Agentic Generative Video Storytelling
- CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding
- A²RD: Agentic Autoregressive Diffusion for Long Video Consistency
- VQQA: An Agentic Approach for Video Evaluation and Quality Improvement
研究結果と製品機能は変わり得ます。制作前に最新論文、利用条件、生成物表示、権利方針を再確認してください。